ವಂಚನೆ-ವಿರೋಧಿ
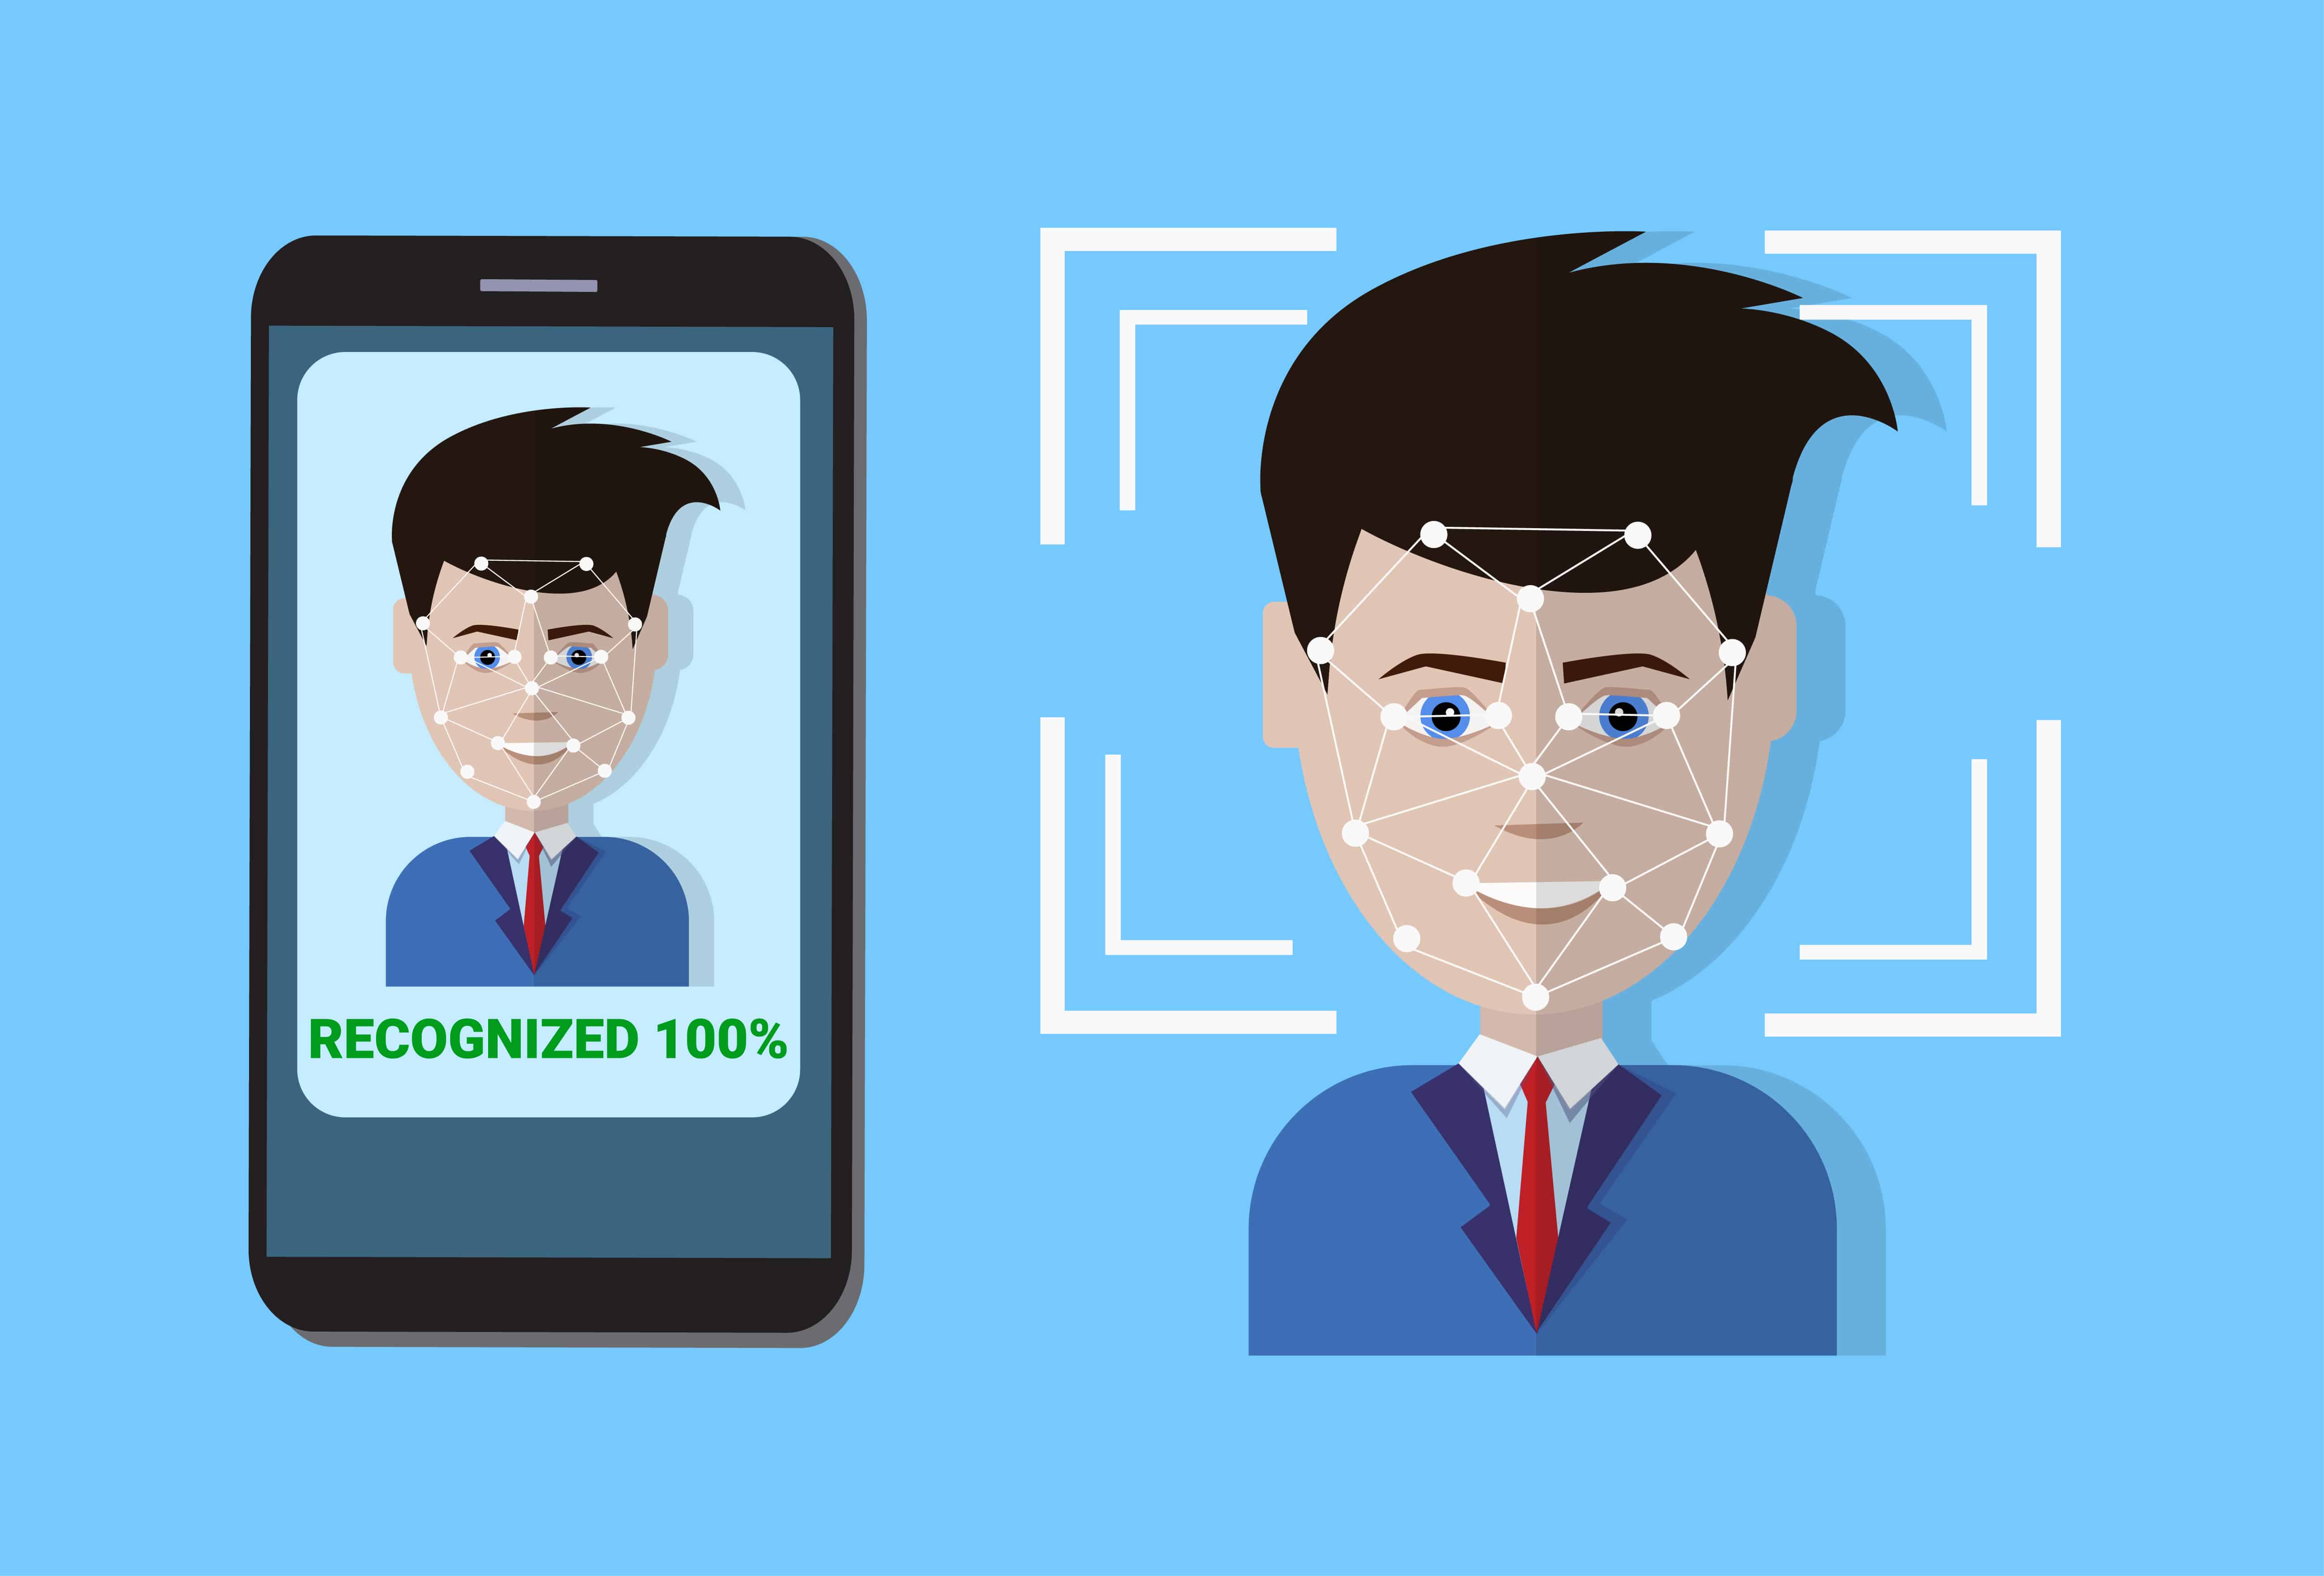
ಇದು ಈಗ ಕ್ಯಾಟಲಾಗ್ನಲ್ಲಿ ಅತಿ ದೊಡ್ಡ ವರ್ಗವಾಗಿದ್ದು, 25 ಡೇಟಾಸೆಟ್ಗಳನ್ನು iBeta ಪ್ರಮಾಣೀಕರಣ ಮಟ್ಟಗಳಿಗೆ ಮ್ಯಾಪ್ ಮಾಡಲಾಗಿದೆ. ಹಂತ 1 ಕವರೇಜ್ 35,800 ವೀಡಿಯೊಗಳು, 22,000 ಪೇಪರ್ ಮಾಸ್ಕ್ ಅಟ್ಯಾಕ್ ವೀಡಿಯೊಗಳು ಮತ್ತು ವೆಬ್ಕ್ಯಾಮ್ ಆನ್ಬೋರ್ಡಿಂಗ್ಗಾಗಿ IR + RGB ಪೇಪರ್ ಅಟ್ಯಾಕ್ಗಳನ್ನು ಒಳಗೊಂಡಿದೆ. ಹಂತ 2 45,522-ವೀಡಿಯೊ ಸೆಟ್, 25,000 3D ಮಾಸ್ಕ್ ಅಟ್ಯಾಕ್ ವೀಡಿಯೊಗಳು, 11,000 ಕ್ಕೂ ಹೆಚ್ಚು ಬಟ್ಟೆ ಮಾಸ್ಕ್ ವೀಡಿಯೊಗಳು ಮತ್ತು 18 ಹೈಪರ್-ರಿಯಲಿಸ್ಟಿಕ್ ಮಾಸ್ಕ್ಗಳಲ್ಲಿ 12,500 ಸಿಲಿಕೋನ್ ಮಾಸ್ಕ್ ಅಟ್ಯಾಕ್ಗಳನ್ನು ಸೇರಿಸುತ್ತದೆ. ಹಂತ 3 ಕ್ಕೆ, 10,000 ಕ್ಕೂ ಹೆಚ್ಚು ಪ್ರೀಮಿಯಂ ರೆಸಿನ್ ಮಾಸ್ಕ್ ಅಟ್ಯಾಕ್ ವೀಡಿಯೊಗಳಿವೆ. ಮರುಪಂದ್ಯ ಕವರೇಜ್ 15 ಸಾಧನಗಳಲ್ಲಿ 5,000+ ಡಿಸ್ಪ್ಲೇ ರಿಪ್ಲೇ ವೀಡಿಯೊಗಳು ಮತ್ತು 3,000 ಮೊಬೈಲ್ ರಿಪ್ಲೇ ಅಟ್ಯಾಕ್ಗಳನ್ನು ಒಳಗೊಂಡಿದೆ.
ಇನ್ನಷ್ಟು ತಿಳಿಯಿರಿ
ಮುಖ ಮತ್ತು ದೇಹದ ಭಾಗಗಳ ಗುರುತಿಸುವಿಕೆ
ಇದು ನವೀಕರಣದ ಅತ್ಯಂತ ಆಳವಾದ ಭಾಗವಾಗಿದೆ. ಹೊಸ ಸೇರ್ಪಡೆಗಳಲ್ಲಿ 10 ಮಿಲಿಯನ್-ಚಿತ್ರಗಳ ಮುಖ ಗುರುತಿಸುವಿಕೆ ಡೇಟಾಸೆಟ್, 44,000-ಚಿತ್ರಗಳ ಏಷ್ಯನ್ ಫೇಶಿಯಲ್ ಸಂಗ್ರಹ, 6,000 ಕ್ಕೂ ಹೆಚ್ಚು ಗುರುತುಗಳನ್ನು ಒಳಗೊಂಡ 70,000-ಚಿತ್ರಗಳ ಸೆಲ್ಫಿ-ಮತ್ತು-ಅಧಿಕೃತ-ಐಡಿ ಡೇಟಾಸೆಟ್ ಮತ್ತು ಭಾರತದಿಂದ 10,000-ಭಾಗವಹಿಸುವವರ ಬಹು-ದೂರ ಸ್ಮಾರ್ಟ್ಫೋನ್ ಫೇಶಿಯಲ್ ಡೇಟಾಸೆಟ್ ಸೇರಿವೆ. ಎರಡು ಐತಿಹಾಸಿಕ ಡೇಟಾಸೆಟ್ಗಳು ಆರು ತಿಂಗಳಿನಿಂದ ಹತ್ತು ವರ್ಷಗಳಿಗಿಂತ ಹೆಚ್ಚು ಕಾಲ ನಿಜವಾದ ವಯಸ್ಸಾದಿಕೆಯನ್ನು ಸಂಶ್ಲೇಷಿತ ವಯಸ್ಸಾದ ಬದಲು ನೈಜ ಛಾಯಾಚಿತ್ರಗಳನ್ನು ಬಳಸಿಕೊಂಡು ಸೆರೆಹಿಡಿಯುತ್ತವೆ, ಇದು ವಯಸ್ಸಿನ-ಬದಲಾಗದ ಗುರುತಿಸುವಿಕೆ ಮತ್ತು KYC ಗೆ ಮುಖ್ಯವಾಗಿದೆ. ಮಕ್ಕಳ ವಯಸ್ಸಿನ ಪ್ರಗತಿ ಡೇಟಾಸೆಟ್ ಮತ್ತು ಸಂಶ್ಲೇಷಿತ ಮಕ್ಕಳ ಮುಖಗಳ ಡೇಟಾಸೆಟ್ ಉತ್ತಮವಾಗಿ ದಾಖಲಿಸಲಾದ ಅಂತರವನ್ನು ಪರಿಹರಿಸುತ್ತದೆ: ಮಕ್ಕಳು ವಯಸ್ಸಿನ ಪತ್ತೆ ಮತ್ತು ಆಳವಾದ ನಕಲಿ ತಡೆಗಟ್ಟುವಿಕೆ ಡೇಟಾದಿಂದ ಹೆಚ್ಚಾಗಿ ಇರುವುದಿಲ್ಲ ಮತ್ತು ಸಂಶ್ಲೇಷಿತ ಸೆಟ್ ಯಾವುದೇ ನೈಜ-ವ್ಯಕ್ತಿ ಡೇಟಾವನ್ನು ಬಳಸದೆ ಜನಸಂಖ್ಯಾ ವ್ಯಾಪ್ತಿಯನ್ನು ವಿಸ್ತರಿಸುತ್ತದೆ.
ಇನ್ನಷ್ಟು ತಿಳಿಯಿರಿ
ಭಾಷೆ ಮತ್ತು ಪಠ್ಯ (OCR)
ಹೊಸ ಸೇರ್ಪಡೆಗಳು ಅರೇಬಿಕ್ ಮತ್ತು ಚೈನೀಸ್ ಕಡೆಗೆ ಒಲವು ತೋರುತ್ತವೆ. ಅವುಗಳಲ್ಲಿ ಸಾರ್ವಜನಿಕ ಆರ್ಕೈವ್ಗಳು ಮತ್ತು ಕೆಲಸ ಮಾಡುವ ಕ್ಯಾಲಿಗ್ರಾಫರ್ಗಳಿಂದ ಸಂಗ್ರಹಿಸಲಾದ 25,000 ಅರೇಬಿಕ್ ಕ್ಯಾಲಿಗ್ರಫಿ ಚಿತ್ರಗಳು, 15,000 ಕೈಬರಹ ಮತ್ತು ಸ್ಕ್ಯಾನ್ ಮಾಡಿದ ಅರೇಬಿಕ್ ದಾಖಲೆಗಳು, ಅರೇಬಿಕ್ ಪಠ್ಯವನ್ನು ಹೊಂದಿರುವ 10,000 ಬೀದಿ ಮತ್ತು ಅಂಗಡಿ ಮುಂಭಾಗದ ಚಿಹ್ನೆಗಳು ಮತ್ತು ಪುಸ್ತಕಗಳು, ಜರ್ನಲ್ಗಳು ಮತ್ತು ಸಾರ್ವಜನಿಕ ನೀತಿ ಸಾಮಗ್ರಿಗಳನ್ನು ವ್ಯಾಪಿಸಿರುವ ಚೀನೀ ಪ್ರಕಟಣೆ ಗ್ರಂಥಾಲಯ ಸೇರಿವೆ. ಹೆಚ್ಚಿನ ತೆರೆದ ಡೇಟಾಸೆಟ್ಗಳು ಕಾರ್ಯನಿರ್ವಹಿಸುವ ಸ್ಕ್ರಿಪ್ಟ್ಗಳಲ್ಲಿ ದೃಶ್ಯ ಪಠ್ಯ ಪತ್ತೆ, ಕೈಬರಹ ಗುರುತಿಸುವಿಕೆ ಮತ್ತು ದಾಖಲೆ ಡಿಜಿಟಲೀಕರಣಕ್ಕೆ ಉಪಯುಕ್ತವಾಗಿದೆ.
ಇನ್ನಷ್ಟು ತಿಳಿಯಿರಿ
ಉಡುಪು ಮತ್ತು ಫ್ಯಾಷನ್
ಚಿಲ್ಲರೆ ಮತ್ತು ಫ್ಯಾಷನ್ ಮಾಡೆಲ್ಗಳು ಸೆಲೆಬ್ರಿಟಿ ಮತ್ತು ಸ್ಟುಡಿಯೋ ಹೆಡ್ಶಾಟ್ಗಳು, ಫ್ಯಾಷನ್ ಮತ್ತು ಸ್ಟುಡಿಯೋ ಸರಣಿಗಳು, ಕ್ರೀಡೆ ಮತ್ತು ಸಕ್ರಿಯ ಉಡುಗೆಗಳು ಮತ್ತು ಉತ್ಪನ್ನ ಮತ್ತು ಜೀವನಶೈಲಿಯ ಚಿತ್ರೀಕರಣಗಳನ್ನು ಒಳಗೊಂಡ 50,000-ಚಿತ್ರಗಳ RAW ಛಾಯಾಗ್ರಹಣ ಡೇಟಾಸೆಟ್ ಅನ್ನು ಸೆಳೆಯಬಹುದು.
ಇನ್ನಷ್ಟು ತಿಳಿಯಿರಿ
ಸನ್ನೆ, ಭಂಗಿ ಮತ್ತು ಚಟುವಟಿಕೆ
ಈ ವರ್ಗದಲ್ಲಿ ಎರಡು ಡೇಟಾಸೆಟ್ಗಳು ಮುಂಚೂಣಿಯಲ್ಲಿವೆ: ಸಂಕೇತ ಭಾಷಾ ಗುರುತಿಸುವಿಕೆ ಮತ್ತು ಅನುವಾದಕ್ಕಾಗಿ ಬಹು ಉಪಭಾಷೆಗಳಲ್ಲಿ 500 ಗಂಟೆಗಳ ಅರೇಬಿಕ್ ಸಂಕೇತ ಭಾಷಾ ವೀಡಿಯೊ, ಮತ್ತು ಪ್ರಪಂಚದಾದ್ಯಂತ 2,000 ಭಾಗವಹಿಸುವವರಿಂದ ಸೆರೆಹಿಡಿಯಲಾದ 24,000-ಚಿತ್ರಗಳ ಸ್ಮಾರ್ಟ್ಫೋನ್ ಪಾಮ್ ಗುರುತಿಸುವಿಕೆ ಸೆಟ್.
ಇನ್ನಷ್ಟು ತಿಳಿಯಿರಿ
ಯಂತ್ರ ಮತ್ತು ಕೈಗಾರಿಕೆ
ವಿಮೆ, ಸಂಚಾರ ಮತ್ತು ಚಲನಶೀಲತೆಯ ಬಳಕೆಯ ಪ್ರಕರಣಗಳು ಉತ್ತಮವಾಗಿ ಕಾರ್ಯನಿರ್ವಹಿಸುತ್ತವೆ: ಯುಕೆಯಿಂದ 69,983 ಹಾನಿಗೊಳಗಾದ ವಾಹನ ಚಿತ್ರಗಳು, ಯುರೋಪಿನಿಂದ ಪರವಾನಗಿ ಫಲಕ ಮತ್ತು ಹಾನಿಗೊಳಗಾದ ಕಾರು ಚಿತ್ರಗಳು, ಯುರೋಪಿನ ಕಾರುಗಳ ಆಟೋಮೋಟಿವ್ ವೀಡಿಯೊ, ಮತ್ತು ದಕ್ಷಿಣ ಆಫ್ರಿಕಾದಿಂದ ವಾಹನದ ದೃಶ್ಯಗಳು, ಪರವಾನಗಿ ಫಲಕದ ಚಿತ್ರಗಳು ಮತ್ತು ಘಟನೆ ಮತ್ತು ಅಸಂಗತತೆ ಪತ್ತೆಗಾಗಿ 56 ಗಂಟೆಗಳ ಅಪಘಾತ ದೃಶ್ಯಗಳನ್ನು ಒಳಗೊಂಡಿರುವ ಸಿಸಿಟಿವಿ ಸಂಗ್ರಹ.
ಇನ್ನಷ್ಟು ತಿಳಿಯಿರಿ
ವಸ್ತು ಮತ್ತು ಬಾಹ್ಯರೇಖೆ ವಿಭಜನೆ
ನಾಲ್ಕು ಡೇಟಾಸೆಟ್ಗಳು ಎದ್ದು ಕಾಣುತ್ತವೆ: ಮಲ್ಟಿಮೋಡಲ್ ಮತ್ತು LLM ತರಬೇತಿಗಾಗಿ ಬಾಣಸಿಗರು ರಚಿಸಿದ 15,000-ಚಿತ್ರಗಳ ಆಹಾರ, ಪಾಕವಿಧಾನ ಮತ್ತು ಅಡುಗೆ ಡೇಟಾಸೆಟ್, ಶೆಲ್ಫ್ ಮಾನಿಟರಿಂಗ್ಗಾಗಿ ದಿನಸಿ ಉತ್ಪನ್ನ ಸಂಗ್ರಹ, SKU ಗುರುತಿಸುವಿಕೆ ಮತ್ತು ಸ್ವಯಂಚಾಲಿತ ಚೆಕ್ಔಟ್, USA ನಿಂದ 200,000 ಮನೆ ಒಳಾಂಗಣ ಮತ್ತು ಹೊರಾಂಗಣ ಫೋಟೋಗಳು ಮತ್ತು ರಿಯಲ್ ಎಸ್ಟೇಟ್, ವಾಹನಗಳು, ಗ್ರಾಹಕ ಎಲೆಕ್ಟ್ರಾನಿಕ್ಸ್ ಮತ್ತು ಸಂಗ್ರಹಣೆಗಳನ್ನು ಒಳಗೊಂಡ 500 ಮಿಲಿಯನ್ಗಿಂತಲೂ ಹೆಚ್ಚು ಚಿತ್ರಗಳ ನೈಜ-ಪ್ರಪಂಚದ ವಸ್ತು ಮತ್ತು ಆಸ್ತಿ ಸಂಗ್ರಹ.
ಇನ್ನಷ್ಟು ತಿಳಿಯಿರಿ
ಅಳತೆಯಲ್ಲಿ ವೀಡಿಯೊ
ವೀಡಿಯೊ ಮತ್ತು ಮಲ್ಟಿಮೋಡಲ್ ಮಾದರಿಗಳನ್ನು ತರಬೇತಿ ಮಾಡುವ ತಂಡಗಳಿಗೆ, 'ಇತರ ಡೇಟಾಸೆಟ್ಗಳು' ವಿಭಾಗವು ಈಗ ಗಂಭೀರ ಪರಿಮಾಣವನ್ನು ಹೊಂದಿದೆ: 80,000 ಗಂಟೆಗಳ YouTube ವೀಡಿಯೊ, 10,000 ಗಂಟೆಗಳ AI ಸಂದರ್ಶನ ವೀಡಿಯೊಗಳು, ಎಂಟು ದೇಶಗಳನ್ನು ವ್ಯಾಪಿಸಿರುವ ಸಾಕ್ಷ್ಯಚಿತ್ರ ನಿರ್ಮಾಪಕರ ಸಂಗ್ರಹದಿಂದ 3,000 ಗಂಟೆಗಳು, 1,000 ಗಂಟೆಗಳ AAA ಗೇಮ್ಪ್ಲೇ ದೃಶ್ಯಗಳು, 1,000 ಗಂಟೆಗಳ ಸಮರ ಕಲೆಗಳ ಹೋರಾಟಗಳು, 1.2 ಮಿಲಿಯನ್ ನಿಮಿಷಗಳ ಪರವಾನಗಿ ಪಡೆದ ಸುದ್ದಿ, ಹವಾಮಾನ, ಕ್ರೀಡೆ ಮತ್ತು ಈವೆಂಟ್ಗಳ ಗ್ರಂಥಾಲಯ ಮತ್ತು ಮಾನವ ಚಟುವಟಿಕೆ, ತುರ್ತುಸ್ಥಿತಿಗಳು ಮತ್ತು ವನ್ಯಜೀವಿಗಳನ್ನು ಒಳಗೊಂಡ 40,000+ ಸ್ಟಾಕ್ ಕ್ಲಿಪ್ಗಳು.
ಇನ್ನಷ್ಟು ತಿಳಿಯಿರಿ