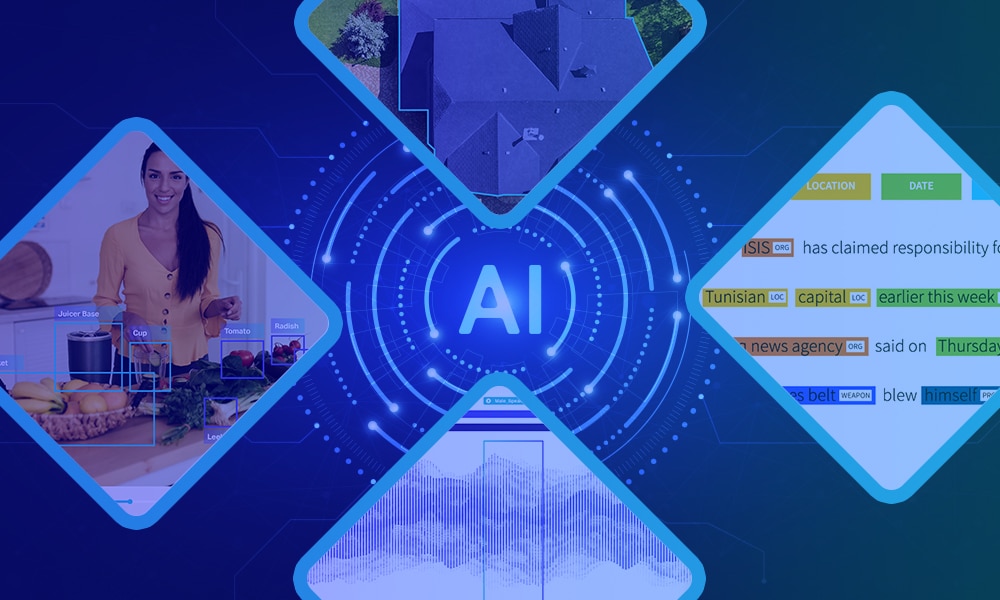
ಪ್ರತಿಯೊಬ್ಬ ML ಎಂಜಿನಿಯರ್ ವಿಶ್ವಾಸಾರ್ಹ ಮತ್ತು ನಿಖರವಾದ AI ಮಾದರಿಯನ್ನು ಅಭಿವೃದ್ಧಿಪಡಿಸಲು ಬಯಸುತ್ತಾರೆ. ಡೇಟಾ ವಿಜ್ಞಾನಿಗಳು ತಮ್ಮ ಸಮಯದ ಸುಮಾರು 80% ರಷ್ಟು ಡೇಟಾವನ್ನು ಲೇಬಲ್ ಮಾಡುವುದು ಮತ್ತು ವೃದ್ಧಿಸಲು ಕಳೆಯುತ್ತಾರೆ. ಅದಕ್ಕಾಗಿಯೇ ಮಾದರಿಯ ಕಾರ್ಯಕ್ಷಮತೆಯು ಅದನ್ನು ತರಬೇತಿ ಮಾಡಲು ಬಳಸುವ ಡೇಟಾದ ಗುಣಮಟ್ಟವನ್ನು ಅವಲಂಬಿಸಿರುತ್ತದೆ.
ನಾವು ವ್ಯವಹಾರಗಳ ವೈವಿಧ್ಯಮಯ AI ಪ್ರಾಜೆಕ್ಟ್ ಅಗತ್ಯಗಳನ್ನು ಪೂರೈಸುತ್ತಿರುವುದರಿಂದ, ನಮ್ಮ ವ್ಯಾಪಾರ ಗ್ರಾಹಕರು ನಮ್ಮನ್ನು ಆಗಾಗ್ಗೆ ಕೇಳುವ ಅಥವಾ ಸ್ಪಷ್ಟತೆಯ ಅಗತ್ಯವಿರುವ ಕೆಲವು ಪ್ರಶ್ನೆಗಳನ್ನು ನಾವು ನೋಡುತ್ತೇವೆ. ಆದ್ದರಿಂದ ML ಮಾದರಿಗಳನ್ನು ನಿಖರವಾಗಿ ತರಬೇತಿ ನೀಡಲು ನಮ್ಮ ಪರಿಣಿತ ತಂಡವು ಚಿನ್ನದ ಗುಣಮಟ್ಟದ ತರಬೇತಿ ಡೇಟಾವನ್ನು ಹೇಗೆ ಅಭಿವೃದ್ಧಿಪಡಿಸುತ್ತದೆ ಎಂಬುದರ ಕುರಿತು ಸಿದ್ಧ ಉಲ್ಲೇಖವನ್ನು ಒದಗಿಸಲು ನಾವು ನಿರ್ಧರಿಸಿದ್ದೇವೆ.
ನಾವು FAQ ಗಳನ್ನು ನ್ಯಾವಿಗೇಟ್ ಮಾಡುವ ಮೊದಲು, ಡೇಟಾ ಲೇಬಲಿಂಗ್ ಮತ್ತು ಅದರ ಪ್ರಾಮುಖ್ಯತೆಯ ಕೆಲವು ಮೂಲಭೂತ ಅಂಶಗಳನ್ನು ವಿವರಿಸೋಣ .
ಡೇಟಾ ಲೇಬಲಿಂಗ್ ಎಂದರೇನು?
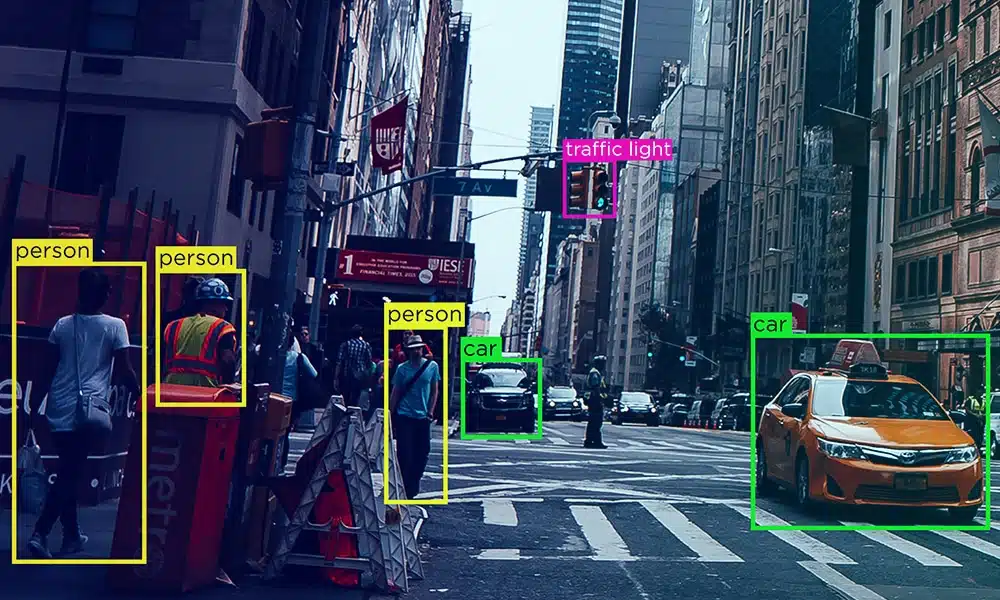
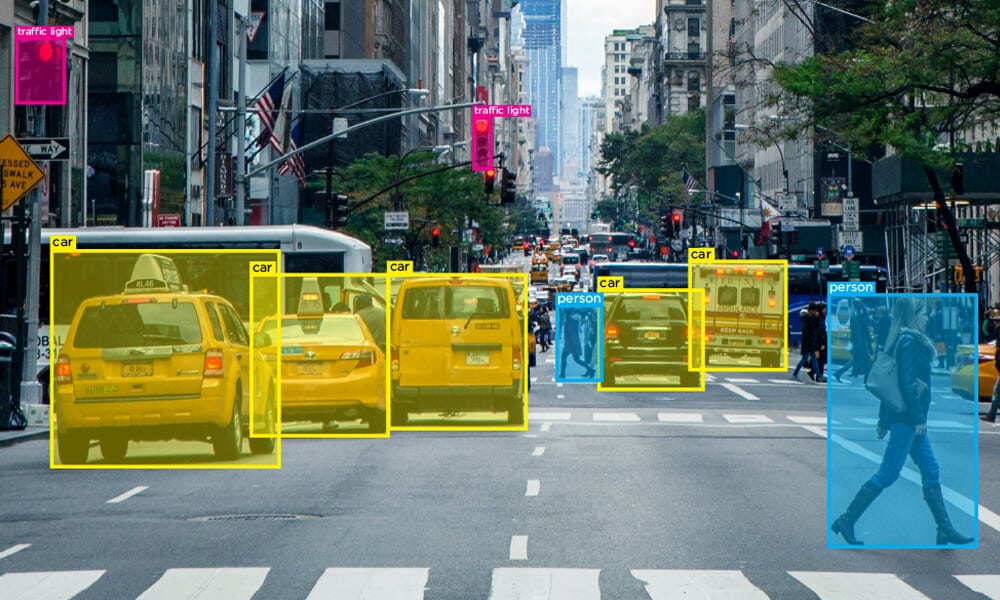
ಡೇಟಾ ಲೇಬಲಿಂಗ್ ಎನ್ನುವುದು ಚಿತ್ರಗಳು, ಆಡಿಯೋ ಅಥವಾ ವೀಡಿಯೊದಂತಹ ಡೇಟಾವನ್ನು ಲೇಬಲ್ ಮಾಡುವ ಅಥವಾ ಟ್ಯಾಗ್ ಮಾಡುವ ಪೂರ್ವ-ಸಂಸ್ಕರಣಾ ಹಂತವಾಗಿದ್ದು , ಇದು ML ಮಾದರಿಗಳಿಗೆ ಸಹಾಯ ಮಾಡುತ್ತದೆ ಮತ್ತು ನಿಖರವಾದ ಮುನ್ಸೂಚನೆಗಳನ್ನು ನೀಡಲು ಅವುಗಳನ್ನು ಸಕ್ರಿಯಗೊಳಿಸುತ್ತದೆ.
ಡೇಟಾ ಲೇಬಲಿಂಗ್ ಅನ್ನು ಯಂತ್ರ ಕಲಿಕೆಯ ಮಾದರಿ ಅಭಿವೃದ್ಧಿಯ ಆರಂಭಿಕ ಹಂತಕ್ಕೆ ಸೀಮಿತಗೊಳಿಸಬೇಕಾಗಿಲ್ಲ ಆದರೆ ಭವಿಷ್ಯವಾಣಿಗಳ ನಿಖರತೆಯನ್ನು ಇನ್ನಷ್ಟು ಸುಧಾರಿಸಲು ನಂತರದ ನಿಯೋಜನೆಯನ್ನು ಮುಂದುವರಿಸಬಹುದು.
ಡೇಟಾ ಲೇಬಲಿಂಗ್ ಪ್ರಾಮುಖ್ಯತೆ

ಡೇಟಾ ಲೇಬಲಿಂಗ್ ಒಂದು ನಿರ್ಣಾಯಕ ಪೂರ್ವ-ಸಂಸ್ಕರಣಾ ಹಂತವಾಗಿದ್ದು ಅದು ನೈಜ-ಪ್ರಪಂಚದ ಪರಿಸರಗಳನ್ನು ವಿಶ್ವಾಸಾರ್ಹವಾಗಿ ಅರ್ಥಮಾಡಿಕೊಳ್ಳುವ ನಿಖರವಾದ ಮಾದರಿಯನ್ನು ನಿರ್ಮಿಸಲು ಸಹಾಯ ಮಾಡುತ್ತದೆ. ನಿಖರವಾಗಿ ಲೇಬಲ್ ಮಾಡಲಾದ ಡೇಟಾಸೆಟ್ಗಳು ನಿಖರವಾದ ಮುನ್ಸೂಚನೆಗಳು ಮತ್ತು ಉತ್ತಮ-ಗುಣಮಟ್ಟದ ಅಲ್ಗಾರಿದಮ್ಗಳನ್ನು ಖಚಿತಪಡಿಸುತ್ತವೆ.
ಸಾಮಾನ್ಯವಾಗಿ ಕೇಳಲಾಗುವ ಪ್ರಶ್ನೆಗಳು
ಭರವಸೆ ನೀಡಿದಂತೆ, ಅಭಿವೃದ್ಧಿ ಜೀವನಚಕ್ರದ ಯಾವುದೇ ಹಂತದಲ್ಲಿ ನೀವು ಹೊಂದಿರಬಹುದಾದ ಎಲ್ಲಾ ಪ್ರಶ್ನೆಗಳಿಗೆ ಮತ್ತು ನೀವು ತಪ್ಪಿಸಬಹುದಾದ ತಪ್ಪುಗಳಿಗೆ ಸಿದ್ಧ ಉಲ್ಲೇಖ ಇಲ್ಲಿದೆ.
ನೀವು ಡೇಟಾವನ್ನು ಹೇಗೆ ಅರ್ಥ ಮಾಡಿಕೊಳ್ಳುತ್ತೀರಿ?
ವ್ಯಾಪಾರವಾಗಿ, ನೀವು ಬೃಹತ್ ಪ್ರಮಾಣದ ಡೇಟಾವನ್ನು ಸಂಗ್ರಹಿಸಿರಬಹುದು ಮತ್ತು ಈಗ ನೀವು - ಆಶಾದಾಯಕವಾಗಿ - ಡೇಟಾದಿಂದ ಪ್ರಮುಖ ಒಳನೋಟಗಳು ಅಥವಾ ಮೌಲ್ಯಯುತ ಮಾಹಿತಿಯನ್ನು ಹೊರತೆಗೆಯಲು ಬಯಸುತ್ತೀರಿ.
ಆದರೆ, ನಿಮ್ಮ ಪ್ರಾಜೆಕ್ಟ್ ಅವಶ್ಯಕತೆಗಳು ಅಥವಾ ವ್ಯಾಪಾರ ಉದ್ದೇಶಗಳ ಸ್ಪಷ್ಟ ತಿಳುವಳಿಕೆಯಿಲ್ಲದೆ, ತರಬೇತಿ ಡೇಟಾವನ್ನು ಪ್ರಾಯೋಗಿಕವಾಗಿ ಬಳಸಲು ನಿಮಗೆ ಸಾಧ್ಯವಾಗುವುದಿಲ್ಲ. ಆದ್ದರಿಂದ ಮಾದರಿಗಳು ಅಥವಾ ಅರ್ಥವನ್ನು ಹುಡುಕಲು ನಿಮ್ಮ ಡೇಟಾವನ್ನು ಶೋಧಿಸಲು ಪ್ರಾರಂಭಿಸಬೇಡಿ. ಬದಲಾಗಿ, ಒಂದು ನಿರ್ದಿಷ್ಟ ಉದ್ದೇಶದೊಂದಿಗೆ ಹೋಗಿ ಆದ್ದರಿಂದ ನೀವು ತಪ್ಪು ಸಮಸ್ಯೆಗಳಿಗೆ ಪರಿಹಾರಗಳನ್ನು ಕಂಡುಕೊಳ್ಳುವುದಿಲ್ಲ.
ತರಬೇತಿ ಡೇಟಾವು ಉತ್ಪಾದನಾ ಡೇಟಾದ ಉತ್ತಮ ಪ್ರತಿನಿಧಿಯೇ? ಇಲ್ಲದಿದ್ದರೆ, ನಾನು ಅದನ್ನು ಹೇಗೆ ಗುರುತಿಸುವುದು?
ನೀವು ಅದನ್ನು ಪರಿಗಣಿಸದಿದ್ದರೂ ಸಹ, ನಿಮ್ಮ ಮಾದರಿಗೆ ತರಬೇತಿ ನೀಡುತ್ತಿರುವ ಲೇಬಲ್ ಡೇಟಾವು ಉತ್ಪಾದನಾ ಪರಿಸರಕ್ಕಿಂತ ಗಮನಾರ್ಹವಾಗಿ ಭಿನ್ನವಾಗಿರಬಹುದು.
ಗುರುತಿಸುವುದು ಹೇಗೆ? ಟೆಲ್-ಟೇಲ್ ಚಿಹ್ನೆಗಳಿಗಾಗಿ ನೋಡಿ. ನಿಮ್ಮ ಮಾದರಿಯು ಪರೀಕ್ಷಾ ಪರಿಸರದಲ್ಲಿ ಉತ್ತಮವಾಗಿ ಕಾರ್ಯನಿರ್ವಹಿಸುತ್ತದೆ ಮತ್ತು ಉತ್ಪಾದನೆಯ ಸಮಯದಲ್ಲಿ ಗಮನಾರ್ಹವಾಗಿ ಕಡಿಮೆಯಾಗಿದೆ.
ಪರಿಹಾರ?
ನಿಖರವಾದ ಅವಶ್ಯಕತೆಗಳನ್ನು ನಿಖರವಾಗಿ ಅರ್ಥಮಾಡಿಕೊಳ್ಳಲು ವ್ಯಾಪಾರ ಅಥವಾ ಡೊಮೇನ್ ತಜ್ಞರೊಂದಿಗೆ ಬೇಸ್ ಅನ್ನು ಸ್ಪರ್ಶಿಸಿ.
-
ಪಕ್ಷಪಾತವನ್ನು ತಗ್ಗಿಸುವುದು ಹೇಗೆ?
ಪಕ್ಷಪಾತವನ್ನು ತಗ್ಗಿಸುವ ಏಕೈಕ ಪರಿಹಾರವೆಂದರೆ ಅವರು ನಿಮ್ಮ ಮಾದರಿಯಲ್ಲಿ ಪರಿಚಯಿಸುವ ಮೊದಲು ಪಕ್ಷಪಾತವನ್ನು ತೆಗೆದುಹಾಕುವಲ್ಲಿ ಪೂರ್ವಭಾವಿಯಾಗಿರುವುದು.
ಡೇಟಾ ಪಕ್ಷಪಾತವು ಯಾವುದೇ ರೂಪದಲ್ಲಿರಬಹುದು - ಪ್ರತಿನಿಧಿಸದ ಡೇಟಾಸೆಟ್ಗಳಿಂದ ಹಿಡಿದು ಪ್ರತಿಕ್ರಿಯೆ ಲೂಪ್ಗಳ ಸಮಸ್ಯೆಗಳವರೆಗೆ. ಇತ್ತೀಚಿನ ಬೆಳವಣಿಗೆಗಳ ಪಕ್ಕದಲ್ಲಿಯೇ ಇಟ್ಟುಕೊಳ್ಳುವುದು ಮತ್ತು ದೃಢವಾದ ಪ್ರಕ್ರಿಯೆಯ ಮಾನದಂಡಗಳು ಮತ್ತು ಚೌಕಟ್ಟನ್ನು ಸ್ಥಾಪಿಸುವುದು ಪಕ್ಷಪಾತದ ವಿವಿಧ ರೂಪಗಳನ್ನು ಎದುರಿಸಲು ಅತ್ಯಗತ್ಯ.
-
ನನ್ನ ತರಬೇತಿ ಡೇಟಾ ಟಿಪ್ಪಣಿ ಪ್ರಕ್ರಿಯೆಗೆ ನಾನು ಹೇಗೆ ಆದ್ಯತೆ ನೀಡುವುದು?
ನಾವು ಕೇಳುವ ಸಾಮಾನ್ಯ ಪ್ರಶ್ನೆಗಳಲ್ಲಿ ಇದು ಒಂದಾಗಿದೆ - ಟಿಪ್ಪಣಿ ಮಾಡುವಾಗ ಡೇಟಾಸೆಟ್ನ ಯಾವ ಭಾಗಕ್ಕೆ ನಾವು ಆದ್ಯತೆ ನೀಡಬೇಕು? ಇದು ಮಾನ್ಯವಾದ ಪ್ರಶ್ನೆಯಾಗಿದೆ, ವಿಶೇಷವಾಗಿ ನೀವು ದೊಡ್ಡ ಡೇಟಾಸೆಟ್ಗಳನ್ನು ಹೊಂದಿರುವಾಗ. ನೀವು ಸಂಪೂರ್ಣ ಸೆಟ್ ಅನ್ನು ಟಿಪ್ಪಣಿ ಮಾಡಬೇಕಾಗಿಲ್ಲ.
ನಿಮ್ಮ ಡೇಟಾಸೆಟ್ನ ನಿರ್ದಿಷ್ಟ ಭಾಗವನ್ನು ಆಯ್ಕೆ ಮಾಡಲು ಮತ್ತು ಅದನ್ನು ಕ್ಲಸ್ಟರ್ ಮಾಡಲು ಸಹಾಯ ಮಾಡುವ ಸುಧಾರಿತ ತಂತ್ರಗಳನ್ನು ನೀವು ಬಳಸಬಹುದು, ಇದರಿಂದ ನೀವು ಟಿಪ್ಪಣಿಗಾಗಿ ಅಗತ್ಯವಿರುವ ಡೇಟಾದ ಉಪವಿಭಾಗವನ್ನು ಮಾತ್ರ ಕಳುಹಿಸಬಹುದು. ಈ ರೀತಿಯಾಗಿ, ನಿಮ್ಮ ಮಾದರಿಯ ಯಶಸ್ಸಿನ ಕುರಿತು ನೀವು ಅತ್ಯಂತ ನಿರ್ಣಾಯಕ ಮಾಹಿತಿಯನ್ನು ಕಳುಹಿಸಬಹುದು.
-
ಅಸಾಧಾರಣ ಸಂದರ್ಭಗಳಲ್ಲಿ ನಾನು ಹೇಗೆ ಕೆಲಸ ಮಾಡುವುದು?
ಅಸಾಧಾರಣ ಪ್ರಕರಣಗಳೊಂದಿಗೆ ವ್ಯವಹರಿಸುವುದು ಪ್ರತಿ ML ಮಾದರಿಗೆ ಸವಾಲಾಗಿರಬಹುದು. ಮಾದರಿಯು ತಾಂತ್ರಿಕವಾಗಿ ಕೆಲಸ ಮಾಡಬಹುದಾದರೂ, ನಿಮ್ಮ ವ್ಯಾಪಾರದ ಅಗತ್ಯಗಳನ್ನು ಪೂರೈಸಲು ಅದು ಒಪ್ಪಂದವನ್ನು ಕಡಿತಗೊಳಿಸದಿರಬಹುದು.

ಈ ಸವಾಲನ್ನು ಎದುರಿಸಲು, ಮಾನವ-ಇನ್-ದಿ-ಲೂಪ್ ಪ್ರತಿಕ್ರಿಯೆ ಮತ್ತು ಮೇಲ್ವಿಚಾರಣೆಯ ಕಲಿಕೆ ನಿರ್ಣಾಯಕವಾಗಿದೆ. ಪರಿಹಾರವು ಹೋಲಿಕೆ ಹುಡುಕಾಟವನ್ನು ಬಳಸುವುದು ಮತ್ತು ಒಂದೇ ರೀತಿಯ ಚಿತ್ರಗಳನ್ನು ಸಂಗ್ರಹಿಸಲು ಸಂಪೂರ್ಣ ಡೇಟಾಸೆಟ್ ಅನ್ನು ಫಿಲ್ಟರ್ ಮಾಡುವುದರಲ್ಲಿದೆ. ಇದರೊಂದಿಗೆ, ನೀವು ಒಂದೇ ರೀತಿಯ ಚಿತ್ರಗಳ ಉಪವಿಭಾಗವನ್ನು ಮಾತ್ರ ಟಿಪ್ಪಣಿ ಮಾಡುವತ್ತ ಗಮನಹರಿಸಬಹುದು ಮತ್ತು ಮಾನವ-ಇನ್-ದಿ-ಲೂಪ್ ವಿಧಾನವನ್ನು ಬಳಸಿಕೊಂಡು ಅದನ್ನು ವರ್ಧಿಸಬಹುದು.
-
ನಾನು ತಿಳಿದಿರಬೇಕಾದ ಯಾವುದೇ ನಿರ್ದಿಷ್ಟ ಲೇಬಲ್ಗಳಿವೆಯೇ?
ನಿಮ್ಮ ಚಿತ್ರಗಳಿಗೆ ಹೆಚ್ಚು ವಿವರ-ಆಧಾರಿತ ಲೇಬಲಿಂಗ್ ಅನ್ನು ಒದಗಿಸಲು ನೀವು ಪ್ರಚೋದಿಸಬಹುದಾದರೂ, ಅದು ಯಾವಾಗಲೂ ಅಗತ್ಯವಾಗಿರುವುದಿಲ್ಲ ಅಥವಾ ಸೂಕ್ತವಾಗಿರುವುದಿಲ್ಲ. ಪ್ರತಿ ಚಿತ್ರಕ್ಕೂ ಹರಳಿನ ಮಟ್ಟದ ವಿವರಗಳು ಮತ್ತು ನಿಖರತೆಯನ್ನು ನೀಡಲು ತೆಗೆದುಕೊಳ್ಳುವ ಸಂಪೂರ್ಣ ಸಮಯ ಮತ್ತು ವೆಚ್ಚವನ್ನು ಸಾಧಿಸುವುದು ಕಷ್ಟ.
ಮಾದರಿಯ ಅಗತ್ಯತೆಗಳ ಬಗ್ಗೆ ನಿಮಗೆ ಸ್ಪಷ್ಟತೆ ಇದ್ದಾಗ ಅತಿಯಾಗಿ ಸೂಚಿಸುವ ಅಥವಾ ಡೇಟಾ ಟಿಪ್ಪಣಿಯಲ್ಲಿ ಹೆಚ್ಚಿನ ನಿಖರತೆಯನ್ನು ಕೇಳಲು ಸೂಚಿಸಲಾಗುತ್ತದೆ.
-
ಎಡ್ಜ್ ಕೇಸ್ಗಳನ್ನು ನೀವು ಹೇಗೆ ಲೆಕ್ಕ ಹಾಕುತ್ತೀರಿ?
ನಿಮ್ಮ ಡೇಟಾ ಟಿಪ್ಪಣಿ ತಂತ್ರವನ್ನು ಸಿದ್ಧಪಡಿಸುವಾಗ ಎಡ್ಜ್ ಕೇಸ್ಗಳಿಗೆ ಖಾತೆ. ಆದಾಗ್ಯೂ, ಮೊದಲಿಗೆ, ನೀವು ಎದುರಿಸಬಹುದಾದ ಪ್ರತಿಯೊಂದು ಅಂಚಿನ ಪ್ರಕರಣವನ್ನು ನಿರೀಕ್ಷಿಸುವುದು ಅಸಾಧ್ಯವೆಂದು ನೀವು ಅರ್ಥಮಾಡಿಕೊಳ್ಳಬೇಕು. ಬದಲಾಗಿ, ನೀವು ವೇರಿಯಬಿಲಿಟಿ ರೇಂಜ್ ಮತ್ತು ಎಡ್ಜ್ ಕೇಸ್ಗಳನ್ನು ಕಂಡುಹಿಡಿಯಬಹುದಾದ ತಂತ್ರವನ್ನು ಆಯ್ಕೆ ಮಾಡಬಹುದು ಮತ್ತು ಅವುಗಳು ಕ್ರಾಪ್ ಅಪ್ ಮಾಡಿದಾಗ ಮತ್ತು ಸಮಯಕ್ಕೆ ಅವುಗಳನ್ನು ಪರಿಹರಿಸಬಹುದು.
-
ಡೇಟಾ ಅಸ್ಪಷ್ಟತೆಯನ್ನು ನಾನು ಯಾವ ರೀತಿಯಲ್ಲಿ ನಿರ್ವಹಿಸಬಹುದು?
ಡೇಟಾಸೆಟ್ನಲ್ಲಿನ ಅಸ್ಪಷ್ಟತೆಯು ತುಂಬಾ ಸಾಮಾನ್ಯವಾಗಿದೆ ಮತ್ತು ನಿಖರವಾದ ಟಿಪ್ಪಣಿಗಾಗಿ ಅದನ್ನು ಹೇಗೆ ಎದುರಿಸಬೇಕೆಂದು ನೀವು ತಿಳಿದಿರಬೇಕು. ಉದಾಹರಣೆಗೆ, ಅರ್ಧ ಮಾಗಿದ ಸೇಬಿನ ಚಿತ್ರವನ್ನು ಹಸಿರು ಸೇಬು ಅಥವಾ ಕೆಂಪು ಸೇಬು ಎಂದು ಲೇಬಲ್ ಮಾಡಬಹುದು.
ಅಂತಹ ಅಸ್ಪಷ್ಟತೆಯನ್ನು ಪರಿಹರಿಸುವ ಕೀಲಿಯು ಮೊದಲಿನಿಂದಲೂ ಸ್ಪಷ್ಟವಾದ ಸೂಚನೆಗಳನ್ನು ಹೊಂದಿದೆ. ಮೊದಲಿಗೆ, ಟಿಪ್ಪಣಿಕಾರರು ಮತ್ತು ವಿಷಯ ತಜ್ಞರ ನಡುವೆ ನಿರಂತರ ಸಂವಹನವನ್ನು ಖಚಿತಪಡಿಸಿಕೊಳ್ಳಿ. ಅಂತಹ ಅಸ್ಪಷ್ಟತೆಯನ್ನು ನಿರೀಕ್ಷಿಸುವ ಮೂಲಕ ಮತ್ತು ಕಾರ್ಯಪಡೆಯಾದ್ಯಂತ ಕಾರ್ಯಗತಗೊಳಿಸಬಹುದಾದ ಮಾನದಂಡಗಳನ್ನು ವ್ಯಾಖ್ಯಾನಿಸುವ ಮೂಲಕ ಪ್ರಮಾಣಿತ ನಿಯಮವನ್ನು ಹೊಂದಿರಿ.
-
ಉತ್ಪಾದನೆಯಲ್ಲಿ ಮಾದರಿ ಕಾರ್ಯಕ್ಷಮತೆಯನ್ನು ಹೆಚ್ಚಿಸಲು ಯಾವುದೇ ಮಾರ್ಗಗಳಿವೆಯೇ?
ಪರೀಕ್ಷಾ ಪರಿಸರ ಮತ್ತು ಉತ್ಪಾದನಾ ದತ್ತಾಂಶವು ಭಿನ್ನವಾಗಿರುವುದರಿಂದ, ಸ್ವಲ್ಪ ಸಮಯದ ನಂತರ ಕಾರ್ಯಕ್ಷಮತೆಯಲ್ಲಿ ವ್ಯತ್ಯಾಸಗಳು ಕಂಡುಬರುತ್ತವೆ. ತರಬೇತಿಯ ಸಮಯದಲ್ಲಿ ಬಹಿರಂಗಪಡಿಸದ ವಿಷಯಗಳನ್ನು ಕಲಿಯಲು ನೀವು ಮಾದರಿಯನ್ನು ನಿರೀಕ್ಷಿಸಲಾಗುವುದಿಲ್ಲ.
ಬದಲಾಗುತ್ತಿರುವ ಉತ್ಪಾದನಾ ದತ್ತಾಂಶಕ್ಕೆ ಅನುಗುಣವಾಗಿ ಪರೀಕ್ಷಾ ದತ್ತಾಂಶವನ್ನು ಇರಿಸಿಕೊಳ್ಳಲು ಪ್ರಯತ್ನಿಸಿ. ಉದಾಹರಣೆಗೆ, ನಿಮ್ಮ ಮಾದರಿಯನ್ನು ಮರುತರಬೇತಿಗೊಳಿಸಿ, ಮಾನವ ಲೇಬಲರ್ಗಳನ್ನು ಒಳಗೊಳ್ಳಿ , ಹೆಚ್ಚು ನಿಖರ ಮತ್ತು ಪ್ರಾತಿನಿಧಿಕ ಸನ್ನಿವೇಶಗಳೊಂದಿಗೆ ಡೇಟಾವನ್ನು ವರ್ಧಿಸಿ ಮತ್ತು ಮರುಪರೀಕ್ಷೆ ಮಾಡಿ ಮತ್ತು ಉತ್ಪಾದನೆಯಲ್ಲಿ ಅದನ್ನು ಬಳಸಿ.
-
ತರಬೇತಿ ಡೇಟಾ ಅಗತ್ಯಗಳ ನನ್ನ ಟಿಪ್ಪಣಿಗಾಗಿ ನಾನು ಯಾರನ್ನು ಸಂಪರ್ಕಿಸಬೇಕು?
ಪ್ರತಿಯೊಂದು ವ್ಯವಹಾರವು ML ಮಾದರಿಗಳನ್ನು ಅಭಿವೃದ್ಧಿಪಡಿಸುವುದರಿಂದ ಏನನ್ನಾದರೂ ಪಡೆಯುತ್ತದೆ. ಕಚ್ಚಾ ಡೇಟಾವನ್ನು ಮೌಲ್ಯಯುತ ಒಳನೋಟವಾಗಿ ಪರಿವರ್ತಿಸಲು ಪ್ರತಿಯೊಂದು ವ್ಯವಹಾರ ಘಟಕವು ತಾಂತ್ರಿಕ ಜ್ಞಾನ ಅಥವಾ ಪರಿಣಿತ ಡೇಟಾ ಲೇಬಲಿಂಗ್ ತಂಡಗಳನ್ನು ಹೊಂದಿರುವುದಿಲ್ಲ . ಸ್ಪರ್ಧಾತ್ಮಕ ಪ್ರಯೋಜನವನ್ನು ಪಡೆಯಲು ನೀವು ಅದನ್ನು ಬಳಸಲು ಸಾಧ್ಯವಾಗುತ್ತದೆ.
ಅಂಶಗಳಿದ್ದರೂ, ನೀವು ಡೇಟಾ ತರಬೇತಿ ಪಾಲುದಾರರಲ್ಲಿ ಹುಡುಕುತ್ತಿರಬಹುದು, ವಿಶ್ವಾಸಾರ್ಹತೆ, ಅನುಭವ ಮತ್ತು ವಿಷಯ ಜ್ಞಾನವು ನೆನಪಿಡುವ ಪ್ರಮುಖ ಮೂರು ಅಂಶಗಳಾಗಿವೆ. ವಿಶ್ವಾಸಾರ್ಹ ಮೂರನೇ ವ್ಯಕ್ತಿಯ ಸೇವಾ ಪೂರೈಕೆದಾರರಿಗೆ ಹೋಗುವ ಮೊದಲು ಇವುಗಳನ್ನು ಪರಿಗಣಿಸಿ.
ನಿಖರ ಮತ್ತು ವಿಶ್ವಾಸಾರ್ಹ ಡೇಟಾ ಲೇಬಲಿಂಗ್ ಸೇವಾ ಪೂರೈಕೆದಾರರ ಪಟ್ಟಿಯಲ್ಲಿ ಶೈಪ್ ಮುಂಚೂಣಿಯಲ್ಲಿದ್ದಾರೆ. ನಿಮ್ಮ ಎಲ್ಲಾ ಲೇಬಲಿಂಗ್ ಮತ್ತು ಡೇಟಾ ಟಿಪ್ಪಣಿ ಅಗತ್ಯಗಳಿಗಾಗಿ ನಾವು ಸುಧಾರಿತ ವಿಶ್ಲೇಷಣೆ, ಅನುಭವ ತಂಡಗಳು ಮತ್ತು ವಿಷಯ ತಜ್ಞರನ್ನು ಬಳಸುತ್ತೇವೆ . ಇದಲ್ಲದೆ, ಪ್ರಮುಖ ವ್ಯವಹಾರಗಳಿಗೆ ಉನ್ನತ-ಮಟ್ಟದ ಟಿಪ್ಪಣಿ ಮತ್ತು ಲೇಬಲಿಂಗ್ ಯೋಜನೆಗಳನ್ನು ಅಭಿವೃದ್ಧಿಪಡಿಸಲು ನಮಗೆ ಸಹಾಯ ಮಾಡಿದ ಪ್ರಮಾಣಿತ ಕಾರ್ಯವಿಧಾನವನ್ನು ನಾವು ಅನುಸರಿಸುತ್ತೇವೆ.